モデルの選び方
Remote Whisper は、処理ごとに別のモデルを使います。軽い処理には小さいモデル、要約のように質が大事な処理には大きいモデルを使うと、速さと質のバランスが取れます。
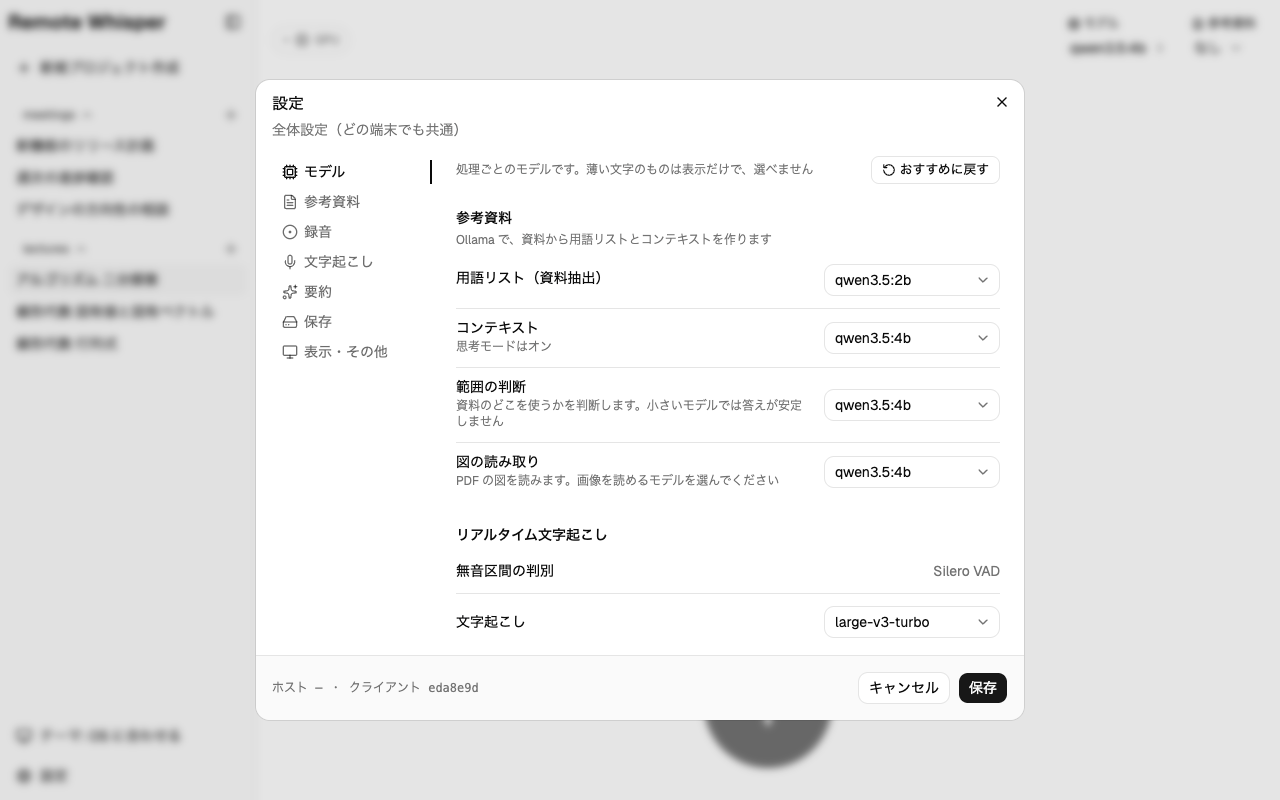
上の簡易設定の「モデル」か、設定の「モデル」で選びます。おすすめの組み合わせに戻すボタンもあります。
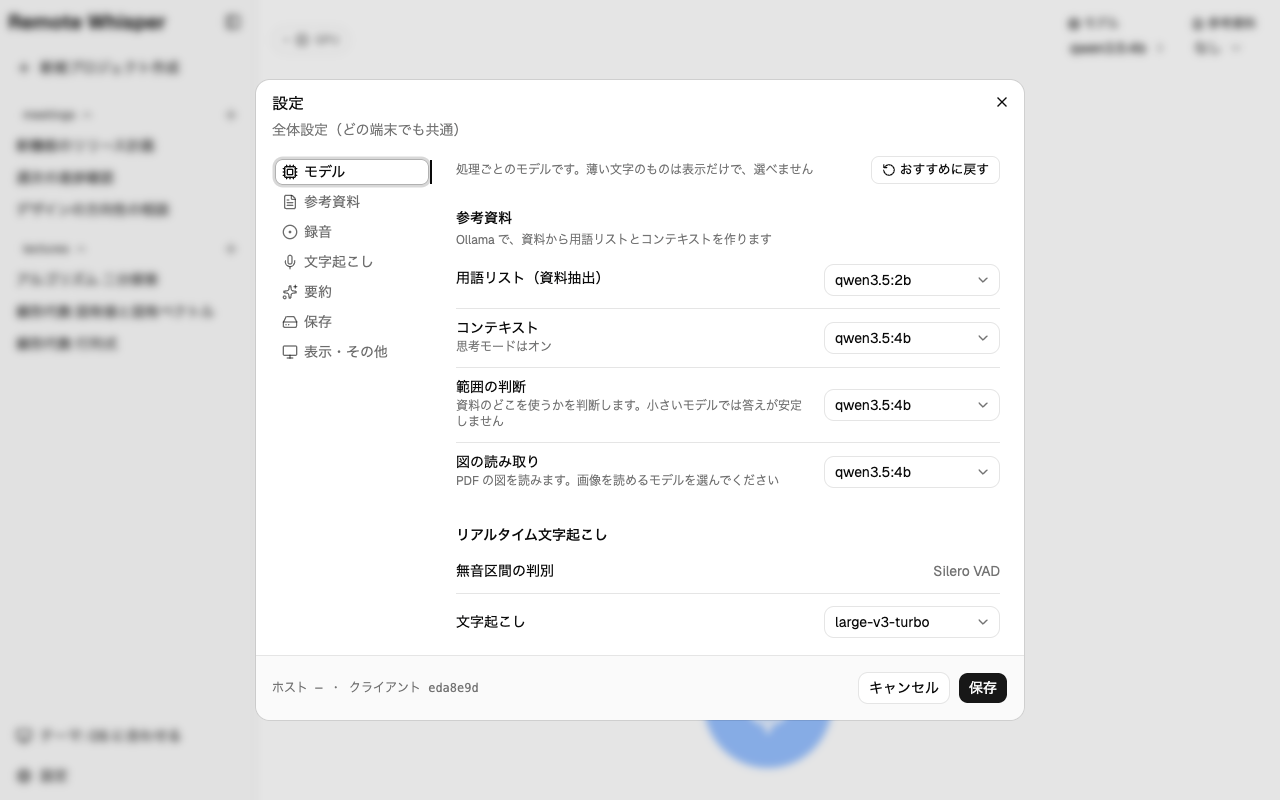
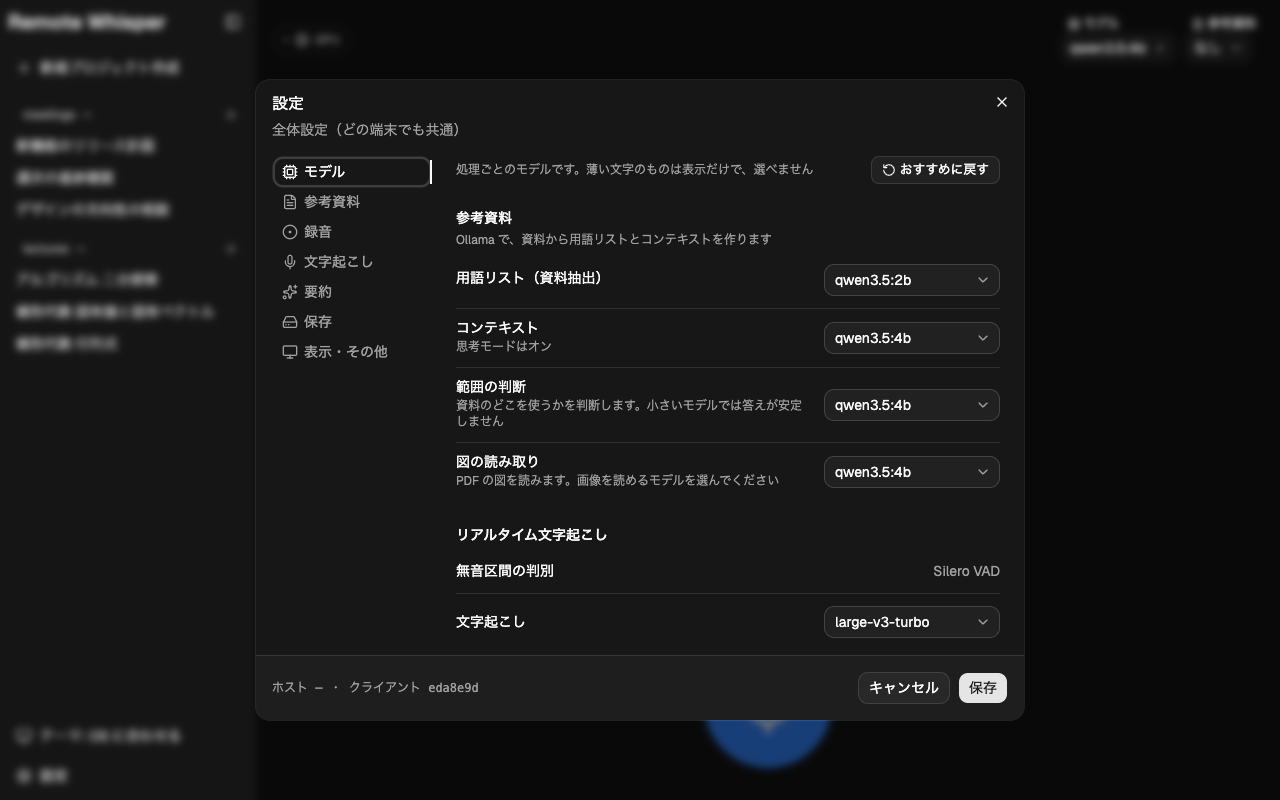
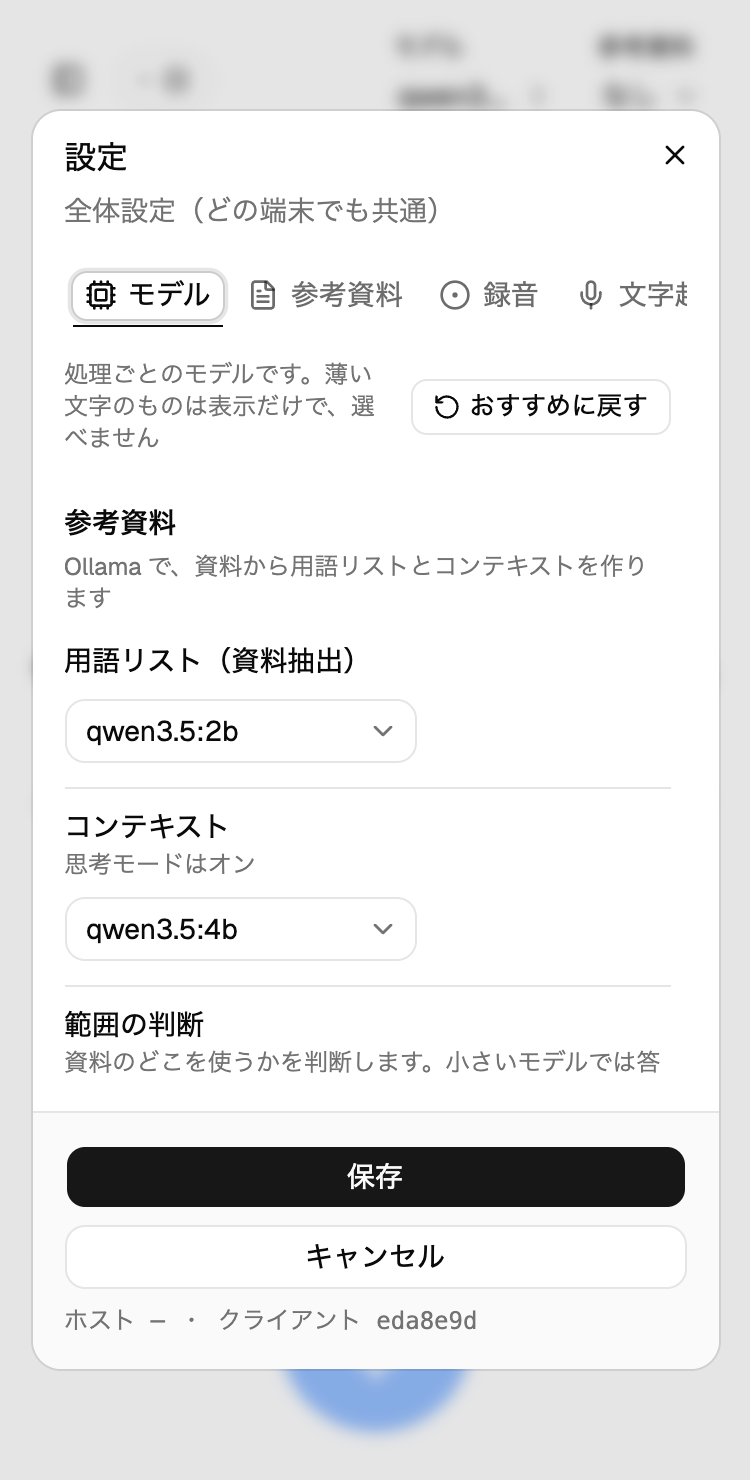
処理とおすすめのモデル
| 区分 | 処理 | おすすめ |
|---|---|---|
| 参考資料 | 用語リスト(資料抽出) | qwen3.5:2b |
| コンテキスト | qwen3.5:4b | |
| 範囲の判断 | qwen3.5:4b | |
| リアルタイム文字起こし | 文字起こし | large-v3-turbo |
| 用語リスト(文字起こし抽出) | qwen3.5:2b | |
| リアルタイム要約 | 要約 | qwen3.5:2b |
| タイトル | qwen3.5:2b | |
| 最終要約 | 全体概要 | qwen3.5:4b |
| 要約詳細 | qwen3.5:4b | |
| タイトル | qwen3.5:0.8b |
- 文字起こしのモデルは large-v3-turbo がおすすめです。large-v3 と同じくらいの精度で、2 倍以上速く動きます。
- Ollama のモデルは、思考モードに対応したものがおすすめです。録音後の要約と用語リストで思考モードを使うと、精度が上がります。
- ホストに入っていないモデルには「入っていません」と出ます。選んだモデルが入っていなければ、入っているモデルで代わりに動きます。
- 大きいモデルほど VRAM を使います。録音中は、Ollama のモデルを 1 つだけ GPU に載せます。