文字起こしの設定
設定の「文字起こし」の項目です。🔒 が付いている項目は、録音中は変えられません。
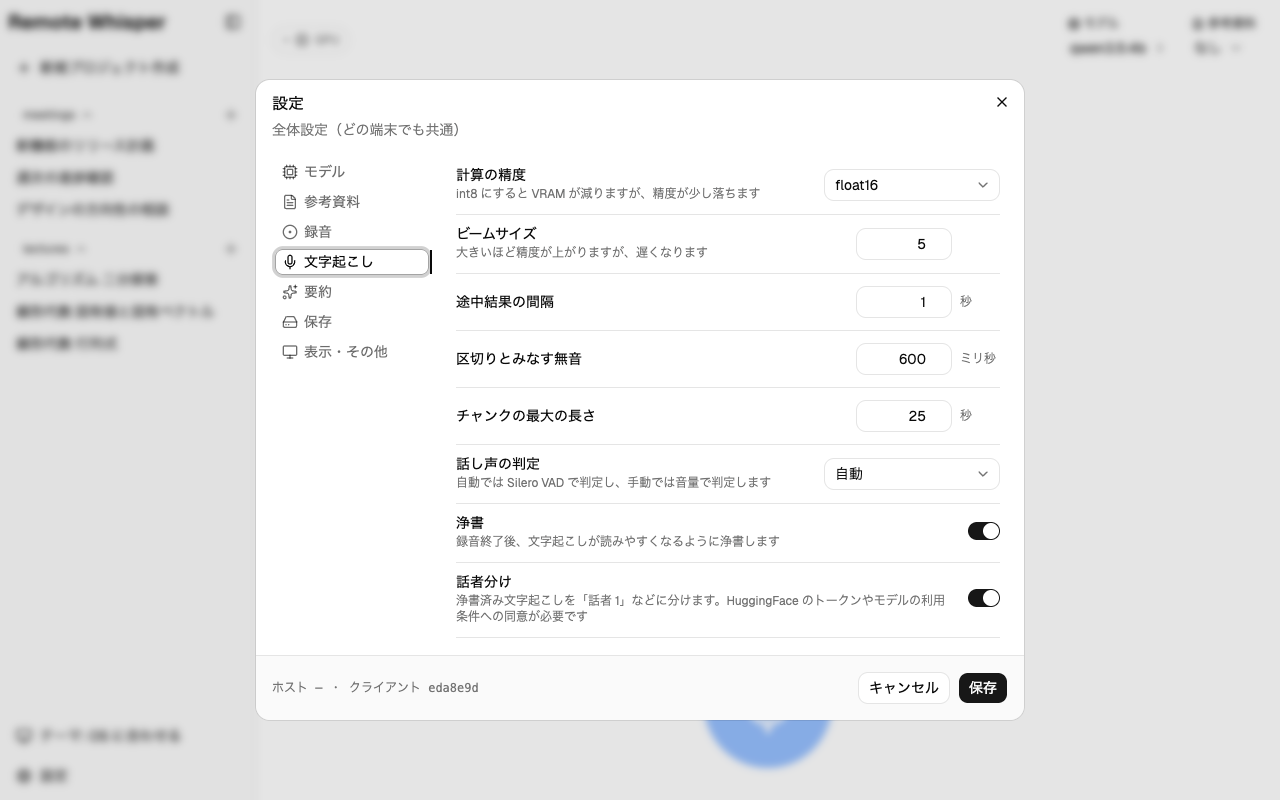
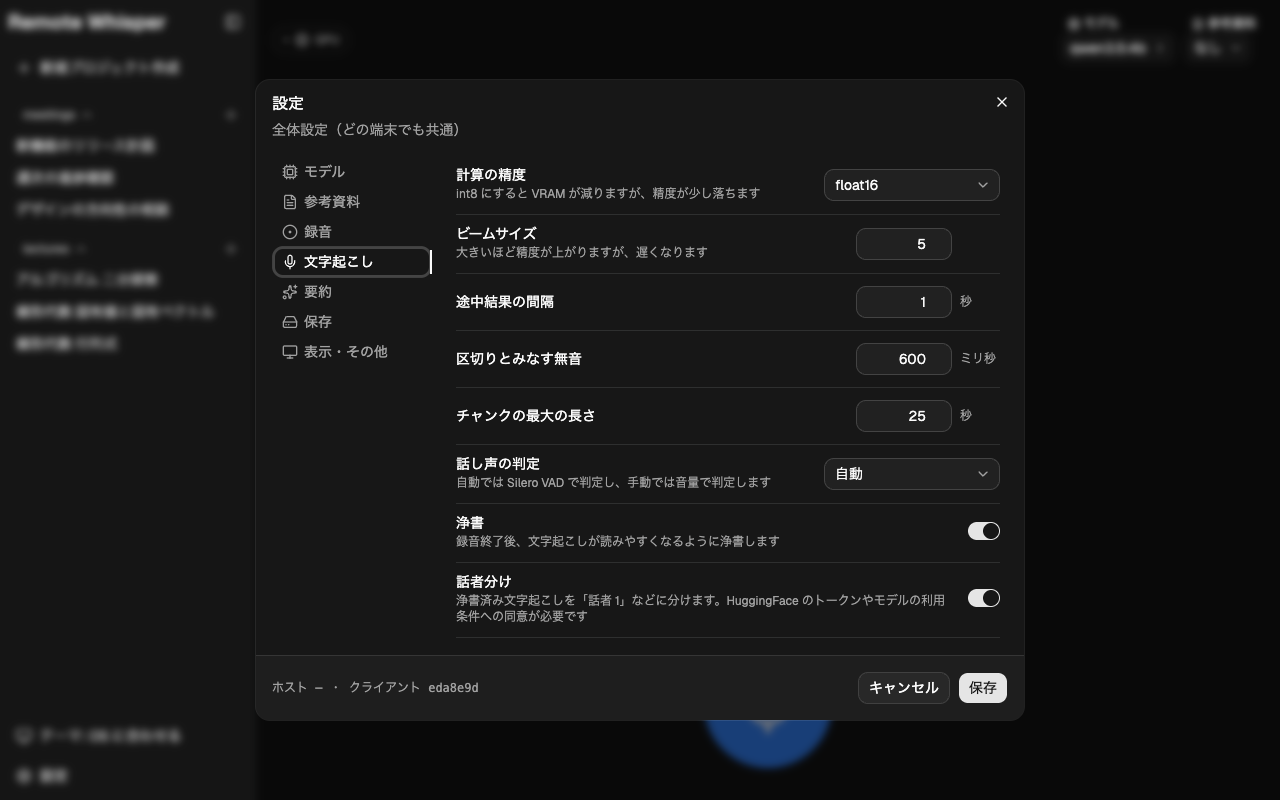
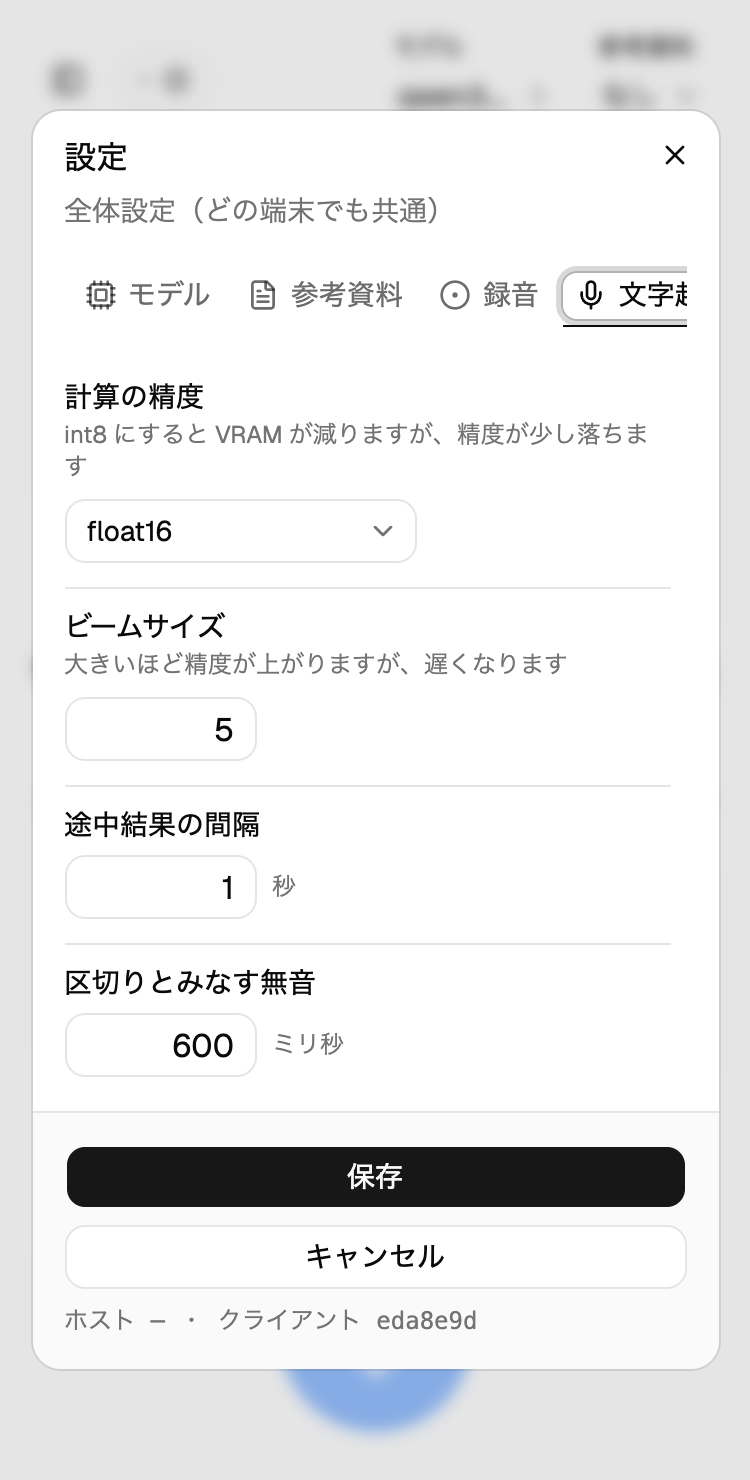
| 項目 | デフォルト | 説明 |
|---|---|---|
| 計算の精度 🔒 | float16 | int8 にすると VRAM が減りますが、精度が少し落ちます |
| ビームサイズ | 5 | 大きいほど精度が上がりますが、遅くなります |
| 途中結果の間隔 | 1 秒 | 話している途中の文字起こしを更新する間隔 |
| 区切りとみなす無音 🔒 | 600 ミリ秒 | これだけ無音が続いたら、1 つの区切りとして確定します |
| チャンクの最大の長さ 🔒 | 25 秒 | 話し続けていても、この長さで区切ります |
| 話し声の判定 🔒 | 自動 | 自動では Silero VAD で、手動では音量で、話しているかを判定します |
| 手動のときの音量 🔒 | -40 dBFS | この音量より大きい音を話し声とみなします(-70〜-10) |
| 浄書 | オン | 録音を終えたら、録音全体から読みやすい文字起こしを作ります(WhisperX が必要) |
| 話者分け | オン | 浄書済み文字起こしを「話者 1」などに分けます。HuggingFace のトークンとモデルの利用条件への同意が必要です |
| 録音終了後にモデルを停止するまでの時間 | 10 分 | 文字起こしのモデルを GPU から下ろすまでの時間 |